

 Français
 English
 Español
 Deutsch
 Italiano
Tokens e janela de contexto: por que a IA perde o fio da meada
Se o seu chatbot perde o fio depois de trinta mensagens, é mecânico. O que são tokens e como manter uma conversa longa.
Na primeira mensagem, você pediu ao seu chatbot que tratasse os leitores por “o senhor” e “a senhora” e nunca passasse de dez linhas. Trinta trocas depois, ele chama todo mundo de “você” e escreve blocos enormes. Não é má vontade nem pane: a sua instrução talvez tenha simplesmente escorregado para fora do que ele ainda consegue ler.
Duas noções explicam esse fenômeno e, com elas, a maioria dos bloqueios nos trabalhos longos: o token e a janela de contexto.
Um token é um pedaço de texto
Os modelos de linguagem não leem letras nem exatamente palavras. Eles cortam o texto em pedaços, os tokens, que são a unidade com a qual trabalham e com a qual se mede a capacidade deles. Se quiser ver onde essa etapa se encaixa no funcionamento geral, leia nossa explicação sobre o que acontece dentro de um modelo de linguagem.
O corte não é natural para um humano. Uma palavra comum como “casa” pode formar um único token, uma palavra rara ou longa como “inconstitucionalissimamente” será cortada em vários, e um sinal de pontuação pode contar à parte. O corte exato depende do modelo.
Para o inglês, a OpenAI dá uma ordem de grandeza muito repetida: um token representa cerca de quatro caracteres, ou seja, aproximadamente três quartos de uma palavra. O português costuma consumir um pouco mais, para um comprimento comparável. Guarde sobretudo a ideia geral: o número de tokens acompanha o tamanho do texto, com uma margem de aproximação. Algumas ferramentas oferecem um contador se você precisar de um número exato.
Esse corte também explica uma esquisitice conhecida. Quando você pergunta quantos “e” tem uma palavra, o modelo não vê necessariamente as letras uma a uma, o que torna a tarefa mais difícil do que parece.
A janela de contexto, sua mesa de trabalho
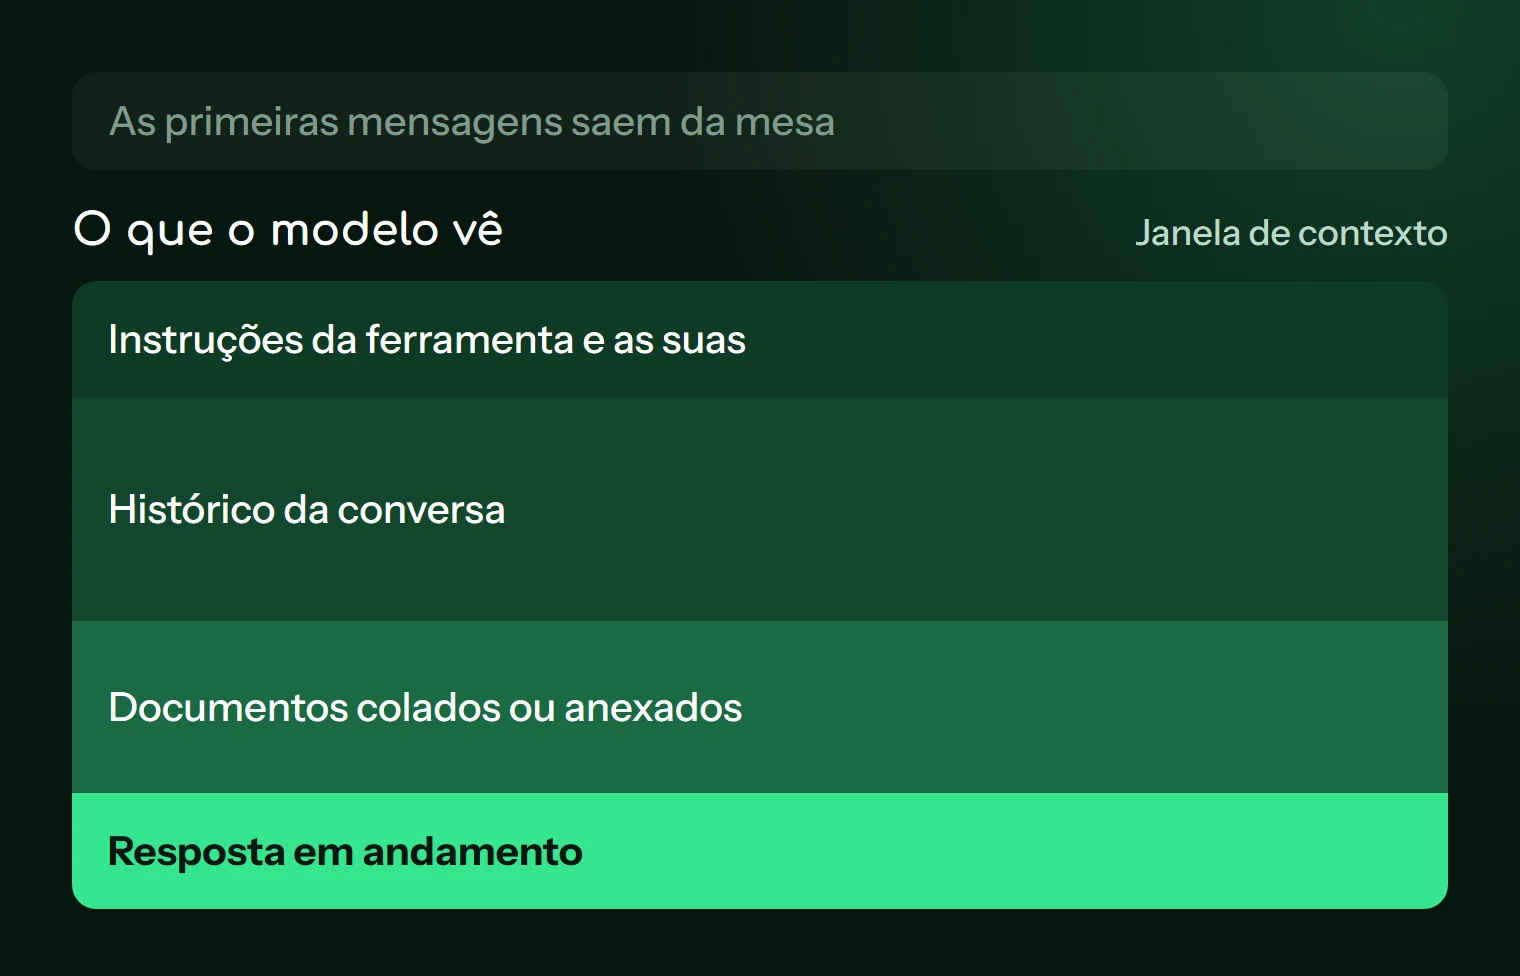
A janela de contexto é a quantidade de tokens que o modelo pode levar em conta ao mesmo tempo. Imagine uma mesa de trabalho: tudo o que está em cima é visível, tudo o que cai da mesa deixa de existir para ele.
Nessa mesa, não há apenas a sua última pergunta:
- as instruções da ferramenta, que você não vê, e as instruções personalizadas que você eventualmente definiu;
- todo o histórico da conversa, as suas mensagens e as respostas dele;
- os documentos colados ou anexados, ou ao menos o que a ferramenta extraiu deles;
- a resposta em andamento, que também ocupa espaço.
Esse último ponto costuma surpreender. Se você enche a mesa com um documento enorme, sobra menos margem para a resposta, que pode ser truncada ou empobrecida.
O tamanho dessa janela varia muito conforme o modelo e o plano, e aumentou bastante nos últimos anos. O número fica velho depressa, então confira-o na documentação da sua ferramenta no momento em que precisar dele.
O que acontece quando a mesa transborda
Aqui também o comportamento depende da ferramenta, e pode mudar. Três casos aparecem na prática. Algumas ferramentas deixam cair as mensagens mais antigas. Outras resumem automaticamente o início da troca, o que preserva o essencial mas perde os detalhes, como uma instrução de estilo dada de passagem. Outras ainda param e pedem que você comece uma nova conversa.
Nos dois primeiros casos, muitas vezes você não recebe nenhum aviso. Estes são os sinais que devem deixar você em alerta:
- ele volta a um hábito que você tinha corrigido;
- ele pergunta de novo uma informação já dada;
- ele se contradiz em relação a uma decisão tomada antes;
- ele cita de forma aproximada um documento longo colado bem no início.
O último caso merece desconfiança: um modelo a quem falta uma passagem nem sempre sinaliza isso, e pode responder mesmo assim de forma plausível.
Uma janela cheia não é o único culpado. Mesmo antes do limite, uma conversa longa acumula tentativas fracassadas e contraordens. Toda essa matéria fica na mesa e pesa na resposta seguinte. Uma conversa curta e limpa muitas vezes dá resultados melhores do que uma conversa longa, mesmo que a capacidade teórica esteja longe de ser atingida.
Quanto ao custo, os tokens também servem de unidade de cobrança nas APIs, na entrada e na saída. As assinaturas para o público geral aplicam antes limites de uso, cujo detalhe evolui. Se você usa só a interface web, os limites dizem respeito a você sobretudo quando trabalha com grandes volumes.
Manter uma conversa longa sem perder o fio
Vamos pegar uma tesoureira de associação que prepara o relatório financeiro em várias sessões. Ela faria bem em evitar a conversa única de 80 mensagens. Eis o que funciona, do mais simples ao mais estruturado.
Uma tarefa, uma conversa. Quando você muda de assunto, abra uma nova discussão. A antiga não vai atrapalhar a nova.
Corrija a sua mensagem em vez de empilhar. Se a resposta sai torta por causa do seu prompt, use a função de editar a mensagem, se a sua ferramenta a oferecer. Assim você evita acrescentar à mesa uma resposta fracassada e a correção dela.
Cole o trecho útil em vez do documento inteiro. Para revisar o capítulo 3 de um regimento interno, o capítulo 3 basta. Para os casos em que você realmente precisa do documento todo, consulte nosso método para trabalhar com documentos longos.
Repita as instruções importantes na hora certa. Uma instrução lembrada logo antes do seu pedido tem mais chance de ser seguida do que uma enterrada trinta mensagens acima.
Faça uma nota de passagem. É o gesto mais rentável. Antes de deixar uma conversa que avançou bem, peça que ela resuma o estado do trabalho e depois recomece desse resumo numa discussão nova.
Vamos continuar este trabalho numa nova conversa, na qual você não terá acesso a nada do que veio antes. Redija uma nota de passagem que eu possa colar exatamente como está.

Ela deve conter:
- o objetivo do trabalho, em duas frases;
- as decisões tomadas e o que foi descartado, com o motivo;
- as instruções de estilo e de formato a respeitar, citando as que eu lhe dei;
- os dados e números exatos a conservar, copiados sem arredondar;
- o que resta a fazer, em ordem.

Não acrescente nenhuma informação que não apareça na nossa conversa. Se um ponto continuar vago ou tiver sido contradito, sinalize numa seção “A confirmar”.
Releia essa nota antes de colá-la: é um resumo produzido pelo modelo, ele pode esquecer um detalhe ou reformular uma instrução de forma torta. Se o seu projeto volta com frequência, você também pode dividi-lo desde o início, seguindo a lógica da cadeia de prompts: cada etapa recebe apenas o que precisa.
Para experimentar na sua conversa atual
Abra a sua conversa ativa mais longa e peça: “Liste as instruções que lhe dei desde o início, copiando-as palavra por palavra.” Compare com o que você realmente escreveu. Se algumas faltarem ou tiverem sido deformadas, você acabou de ver o limite em ação, e tem a sua nota de passagem a fazer antes de continuar.
Para ler em seguida
Entender a IA
Verificar uma resposta da IA: o que checar e como
Datas, números, fontes inventadas, código: como checar uma resposta da IA conforme o risco, sem gastar o seu dia nisso.
5 min de leitura
Entender a IA
O AI Act explicado de forma simples: o que muda para você
O regulamento europeu de IA classifica os usos por nível de risco. O que isso muda se você usa um chatbot no trabalho, e um prompt de inventário.
5 min de leitura
Entender a IA
Viés da IA: como identificar e reduzir
Estereótipos, reflexos anglo-saxões, bajulação: um teste simples para detectar o viés da IA e prompts para corrigi-lo no dia a dia.
6 min de leitura