

 Français
 English
 Español
 Deutsch
 Português
Token e finestra di contesto: perché l'IA perde il filo
Se il tuo chatbot perde il filo dopo trenta messaggi, è meccanico. Che cosa sono i token e come portare avanti una conversazione lunga.
Nel primo messaggio hai chiesto al tuo chatbot di dare del Lei ai lettori e di non superare mai le dieci righe. Trenta scambi dopo, dà del tu a tutti e scrive muri di testo. Non è cattiva volontà né un guasto: la tua istruzione potrebbe semplicemente essere scivolata fuori da ciò che riesce ancora a leggere.
Due nozioni spiegano questo fenomeno e, con esse, la maggior parte dei blocchi nei lavori lunghi: il token e la finestra di contesto.
Un token è un pezzo di testo
I modelli linguistici non leggono né lettere né esattamente parole. Spezzettano il testo in pezzi, i token, che sono l'unità con cui lavorano e con cui se ne misura la capacità. Se vuoi vedere dove si colloca questa fase nel funzionamento generale, leggi la nostra spiegazione di che cosa succede in un modello linguistico.
La suddivisione non è naturale per un essere umano. Una parola comune come «casa» può formare un solo token, una parola rara o lunga come «incostituzionalmente» sarà tagliata in più pezzi, e un segno di punteggiatura può contare a parte. La suddivisione esatta dipende dal modello.
Per l'inglese, OpenAI dà un ordine di grandezza spesso ripreso: un token rappresenta circa quattro caratteri, cioè all'incirca tre quarti di una parola. L'italiano ne consuma spesso un po' di più, a parità di lunghezza. Tieni soprattutto l'idea generale: il numero di token segue la lunghezza del testo, con un margine di approssimazione. Alcuni strumenti offrono un contatore se ti serve un numero preciso.
Questa suddivisione spiega anche una stranezza nota. Quando chiedi quante «e» contiene una parola, il modello non vede necessariamente le lettere una per una, il che rende il compito più difficile di quanto sembri.
La finestra di contesto, il tuo piano di lavoro
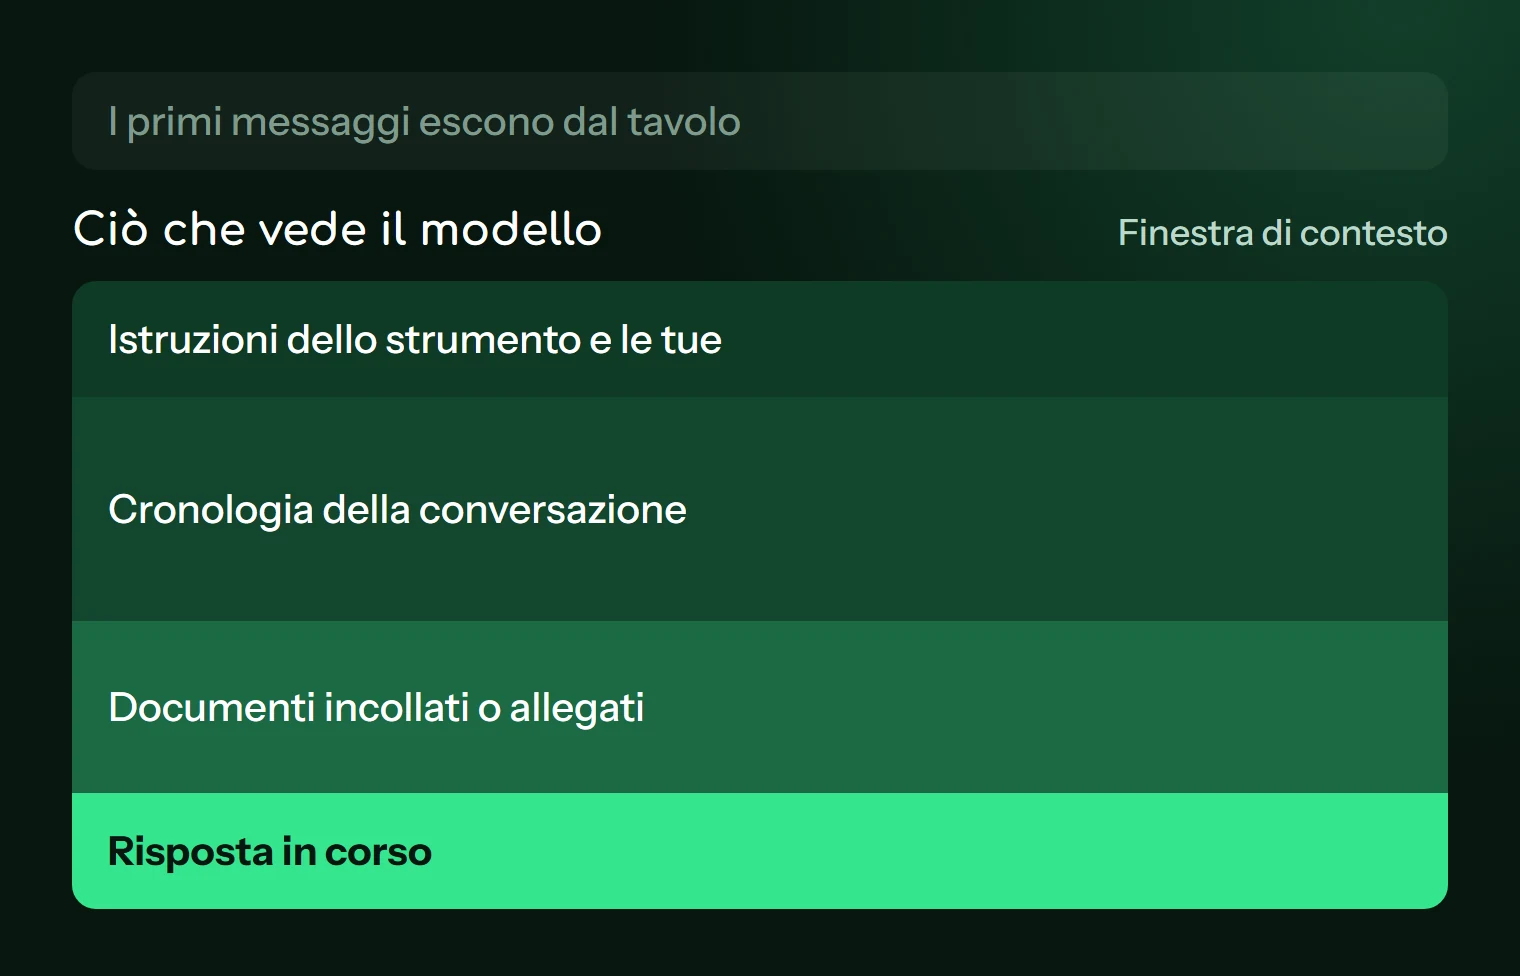
La finestra di contesto è la quantità di token che il modello può prendere in considerazione contemporaneamente. Immagina un piano di lavoro: tutto ciò che c'è sopra è visibile, tutto ciò che cade dal piano non esiste più per lui.
Su quel piano non c'è solo la tua ultima domanda:
- le istruzioni dello strumento, che non vedi, e le istruzioni personalizzate che hai eventualmente definito;
- tutta la cronologia della conversazione, i tuoi messaggi come le sue risposte;
- i documenti incollati o allegati, o almeno ciò che lo strumento ne ha estratto;
- la risposta in corso di scrittura, che occupa spazio anch'essa.
Quest'ultimo punto sorprende spesso. Se riempi il piano con un documento enorme, resta meno margine per la risposta, che può risultare troncata o impoverita.
La dimensione di questa finestra varia molto in base al modello e al piano, ed è aumentata nettamente negli ultimi anni. Il numero invecchia in fretta, quindi verificalo nella documentazione del tuo strumento nel momento in cui ti serve.
Che cosa succede quando il piano trabocca
Anche qui il comportamento dipende dallo strumento e può cambiare. In pratica si incontrano tre casi. Alcuni strumenti lasciano cadere i messaggi più vecchi. Altri riassumono automaticamente l'inizio dello scambio, il che preserva l'essenziale ma perde i dettagli, come un'istruzione di stile data di passaggio. Altri ancora si fermano e ti chiedono di cominciare una nuova conversazione.
Nei primi due casi non ricevi spesso nessun avviso. Ecco i segnali che devono metterti in allerta:
- torna a un'abitudine che avevi corretto;
- richiede un'informazione già data;
- si contraddice rispetto a una decisione presa prima;
- cita in modo approssimativo un lungo documento incollato proprio all'inizio.
L'ultimo caso merita diffidenza: un modello a cui manca un passaggio non sempre lo segnala, può rispondere comunque in modo plausibile.
Una finestra piena non è l'unica colpevole. Anche prima del limite, una conversazione lunga accumula tentativi falliti e contrordini. Tutta questa materia resta sul piano e pesa sulla risposta successiva. Una conversazione breve e pulita dà spesso risultati migliori di una lunga, anche se la capacità teorica è ben lontana dall'essere raggiunta.
Sul fronte dei costi, i token sono anche l'unità di fatturazione per le API, sia in ingresso sia in uscita. Gli abbonamenti per il grande pubblico applicano piuttosto limiti d'uso, il cui dettaglio evolve. Se usi solo l'interfaccia web, i limiti ti riguardano soprattutto quando lavori su grandi volumi.
Portare avanti una conversazione lunga senza perdere il filo
Prendiamo la tesoriera di un'associazione che prepara il suo rendiconto finanziario in più sedute. Ha tutto l'interesse a evitare l'unica conversazione da 80 messaggi. Ecco che cosa funziona, dal più semplice al più strutturato.
Un compito, una conversazione. Quando cambi argomento, apri una nuova discussione. La vecchia non disturberà la nuova.
Correggi il messaggio invece di accumulare. Se la risposta parte storta per colpa del tuo prompt, usa la funzione di modifica del messaggio, se il tuo strumento la offre. Eviti di aggiungere al piano una risposta sbagliata e la sua correzione.
Incolla l'estratto utile invece del documento intero. Per rileggere il capitolo 3 di un regolamento interno, basta il capitolo 3. Per i casi in cui ti serve davvero tutto il documento, consulta il nostro metodo per lavorare con documenti lunghi.
Rimetti le istruzioni importanti al momento giusto. Un'istruzione ripetuta subito prima della tua richiesta ha più probabilità di essere seguita di una sepolta trenta messaggi più su.
Fai una nota di passaggio di consegne. È il gesto più redditizio. Prima di lasciare una conversazione che è andata bene avanti, chiedile di riassumere lo stato del lavoro, poi riparti da quel riassunto in una discussione nuova.
Proseguiremo questo lavoro in una nuova conversazione, in cui non avrai accesso a nulla di ciò che precede. Scrivi una nota di passaggio di consegne che io possa incollare così com'è.

Deve contenere:
- l'obiettivo del lavoro, in due frasi;
- le decisioni prese e ciò che è stato scartato, con il motivo;
- le istruzioni di stile e di formato da rispettare, citando quelle che ti ho dato;
- i dati e i numeri esatti da conservare, ricopiati senza arrotondarli;
- ciò che resta da fare, in ordine.

Non aggiungere nessuna informazione che non compaia nella nostra conversazione. Se un punto resta poco chiaro o è stato contraddetto, segnalalo in una sezione «Da confermare».
Rileggi questa nota prima di incollarla: è un riassunto prodotto dal modello, può dimenticare un dettaglio o riformulare male un'istruzione. Se il tuo progetto si ripresenta spesso, puoi anche suddividerlo fin dall'inizio, seguendo la logica della catena di prompt: ogni passaggio riceve solo ciò di cui ha bisogno.
Da provare sulla tua conversazione in corso
Apri la tua conversazione attiva più lunga e chiedi: «Elenca le istruzioni che ti ho dato fin dall'inizio, ricopiandole parola per parola.» Confronta con ciò che hai davvero scritto. Se alcune mancano o sono state deformate, hai appena visto il limite in azione, e hai la tua nota di passaggio di consegne da fare prima di continuare.
Da leggere dopo
Capire l’IA
Verificare una risposta dell'IA: che cosa controllare, e come
Date, numeri, fonti inventate, codice: come controllare una risposta dell'IA in base al rischio, senza passarci la giornata.
5 min di lettura
Capire l’IA
L'AI Act spiegato semplice: cosa ti riguarda
Il regolamento europeo sull'IA classifica gli usi per livello di rischio. Cosa cambia se usi un chatbot al lavoro, più un prompt per fare l'inventario.
5 min di lettura
Capire l’IA
Bias dell'IA: come riconoscerli e limitarli
Stereotipi, riflessi anglosassoni, compiacenza: un test semplice per individuare i bias dell'IA e prompt per correggerli ogni giorno.
6 min di lettura