

 Français
 English
 Deutsch
 Italiano
 Português
Tokens y ventana de contexto: por qué la IA pierde el hilo
Si tu chatbot pierde el hilo después de treinta mensajes, es algo mecánico. Qué son los tokens y cómo mantener una conversación larga.
En el primer mensaje le pediste a tu chatbot que tratara de usted a los lectores y que nunca pasara de diez líneas. Treinta intercambios después, trata a todo el mundo de tú y escribe parrafadas. No es mala voluntad ni una avería: tu instrucción quizá se ha deslizado simplemente fuera de lo que todavía consigue leer.
Dos nociones explican este fenómeno y, con ellas, la mayoría de los bloqueos en los trabajos largos: el token y la ventana de contexto.
Un token es un trozo de texto
Los modelos de lenguaje no leen letras ni exactamente palabras. Trocean el texto en fragmentos, los tokens, que son la unidad con la que trabajan y con la que se mide su capacidad. Si quieres ver dónde encaja este paso en el funcionamiento general, lee nuestra explicación de lo que ocurre dentro de un modelo de lenguaje.
El troceado no es natural para un humano. Una palabra corriente como «casa» puede formar un solo token, una palabra rara o larga como «anticonstitucionalmente» se cortará en varios, y un signo de puntuación puede contar aparte. El troceado exacto depende del modelo.
Para el inglés, OpenAI da un orden de magnitud que se repite a menudo: un token representa aproximadamente cuatro caracteres, es decir, más o menos tres cuartos de palabra. El español suele consumir algo más, a igual longitud. Quédate sobre todo con la idea general: el número de tokens sigue la longitud del texto, con un margen de aproximación. Algunas herramientas ofrecen un contador si necesitas una cifra precisa.
Este troceado explica también una rareza conocida. Cuando preguntas cuántas «e» tiene una palabra, el modelo no ve necesariamente las letras una a una, lo que hace la tarea más difícil de lo que parece.
La ventana de contexto, tu mesa de trabajo
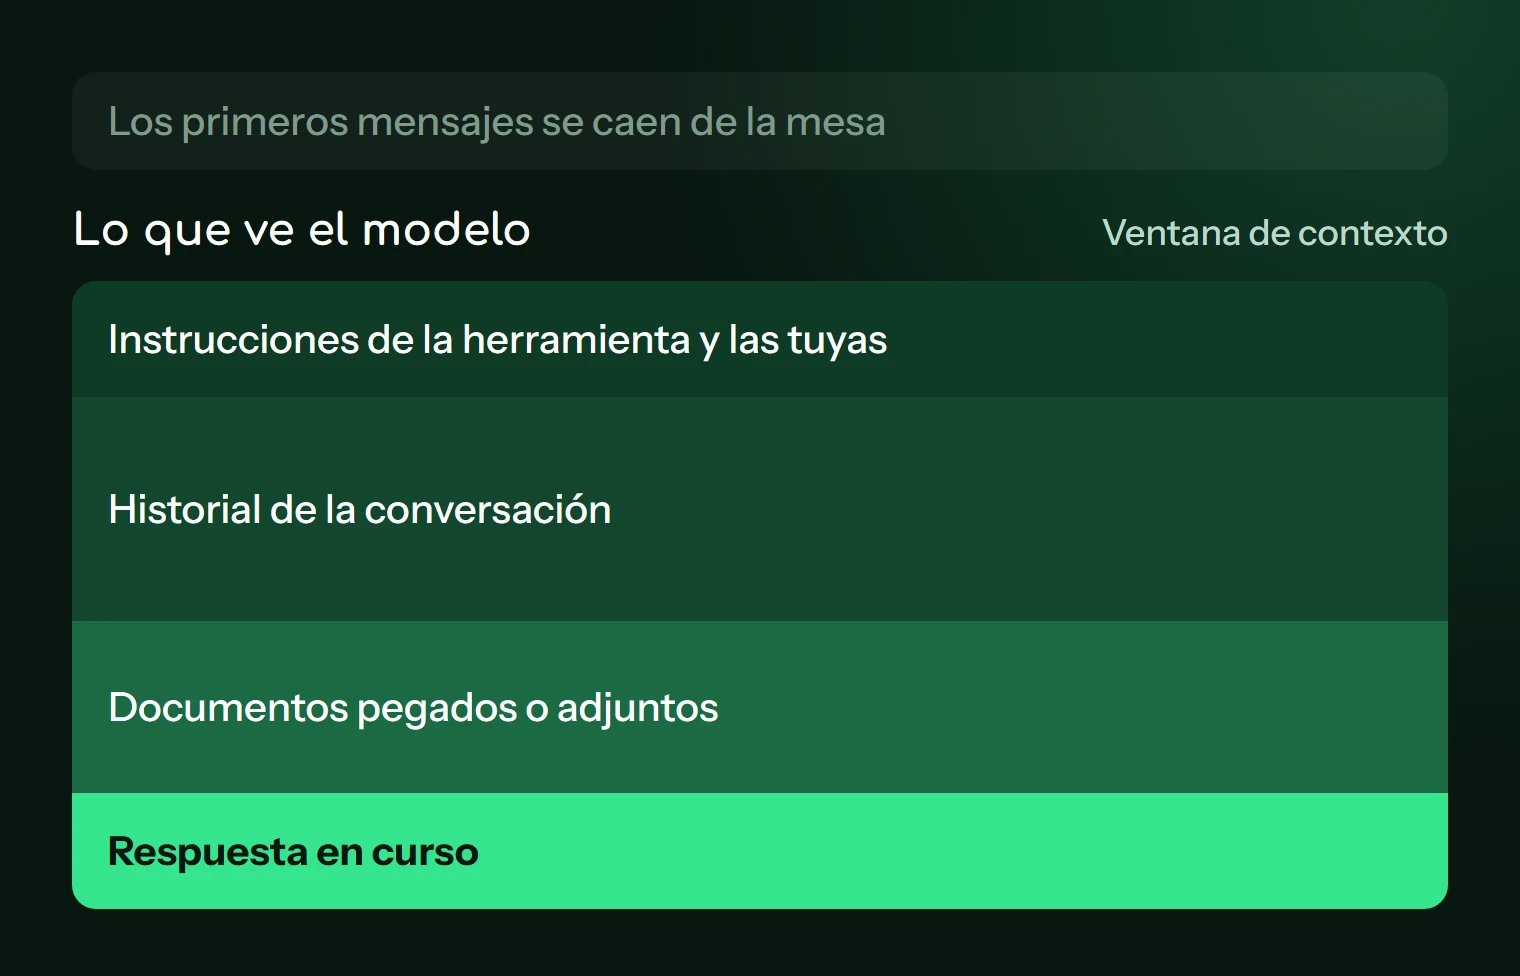
La ventana de contexto es la cantidad de tokens que el modelo puede tener en cuenta a la vez. Imagínate una mesa de trabajo: todo lo que hay encima es visible, todo lo que cae de la mesa deja de existir para él.
En esa mesa no está solo tu última pregunta:
- las instrucciones de la herramienta, que no ves, y las instrucciones personalizadas que hayas podido definir;
- todo el historial de la conversación, tus mensajes y sus respuestas;
- los documentos pegados o adjuntos, o al menos lo que la herramienta ha extraído de ellos;
- la respuesta que se está redactando, que también ocupa sitio.
Este último punto suele sorprender. Si llenas la mesa con un documento enorme, queda menos margen para la respuesta, que puede quedar truncada o empobrecida.
El tamaño de esta ventana varía mucho según el modelo y el plan, y ha aumentado notablemente en los últimos años. La cifra caduca enseguida, así que compruébala en la documentación de tu herramienta en el momento en que la necesites.
Qué pasa cuando la mesa se desborda
También aquí el comportamiento depende de la herramienta, y puede cambiar. En la práctica se dan tres casos. Algunas herramientas dejan caer los mensajes más antiguos. Otras resumen automáticamente el principio del intercambio, lo que preserva lo esencial pero pierde los detalles, como una pauta de estilo dada de pasada. Otras, en fin, se detienen y te piden que empieces una conversación nueva.
En los dos primeros casos, a menudo no recibes ningún aviso. Estas son las señales que deben ponerte en guardia:
- vuelve a un hábito que habías corregido;
- te pide otra vez una información ya dada;
- se contradice respecto a una decisión tomada antes;
- cita de forma aproximada un documento largo pegado al principio del todo.
El último caso merece desconfianza: un modelo al que le falta un pasaje no siempre lo señala, y puede responder de todas formas con algo plausible.
Una ventana llena no es el único culpable. Incluso antes del límite, una conversación larga acumula intentos fallidos y órdenes y contraórdenes. Toda esa materia permanece sobre la mesa y pesa en la respuesta siguiente. Una conversación corta y limpia suele dar mejores resultados que una larga, aunque la capacidad teórica esté lejos de alcanzarse.
En cuanto al coste, los tokens sirven también como unidad de facturación en las API, tanto de entrada como de salida. Las suscripciones para el público general aplican más bien límites de uso, cuyo detalle evoluciona. Si solo usas la interfaz web, los límites te afectan sobre todo cuando trabajas con grandes volúmenes.
Mantener una conversación larga sin perder el hilo
Tomemos a una tesorera de asociación que prepara su informe financiero en varias sesiones. Le conviene evitar la conversación única de 80 mensajes. Esto es lo que funciona, de lo más sencillo a lo más estructurado.
Una tarea, una conversación. Cuando cambies de tema, abre una conversación nueva. La antigua no estorbará a la nueva.
Corrige tu mensaje en lugar de apilar. Si la respuesta se tuerce por culpa de tu prompt, usa la función de editar el mensaje, si tu herramienta la ofrece. Evitas añadir a la mesa una respuesta fallida y su corrección.
Pega el extracto útil en lugar del documento entero. Para revisar el capítulo 3 de un reglamento interno, basta con el capítulo 3. Para los casos en los que de verdad necesitas todo el documento, consulta nuestro método para trabajar con documentos largos.
Vuelve a poner las instrucciones importantes en el momento oportuno. Una instrucción recordada justo antes de tu petición tiene más probabilidades de seguirse que una enterrada treinta mensajes más arriba.
Haz una nota de traspaso. Es el gesto más rentable. Antes de abandonar una conversación que ha avanzado bien, pídele que resuma el estado del trabajo y parte después de ese resumen en una conversación nueva.
Vamos a continuar este trabajo en una conversación nueva, donde no tendrás acceso a nada de lo anterior. Redacta una nota de traspaso que pueda pegar tal cual.

Debe contener:
- el objetivo del trabajo, en dos frases;
- las decisiones tomadas y lo que se ha descartado, con la razón;
- las pautas de estilo y de formato que hay que respetar, citando las que te he dado;
- los datos y cifras exactos que hay que conservar, copiados sin redondear;
- lo que queda por hacer, en orden.

No añadas ninguna información que no aparezca en nuestra conversación. Si algún punto sigue poco claro o se ha contradicho, señálalo en una sección «Por confirmar».
Relee esta nota antes de pegarla: es un resumen producido por el modelo, puede olvidar un detalle o reformular mal una instrucción. Si tu proyecto vuelve a menudo, también puedes dividirlo desde el principio siguiendo la lógica de la cadena de prompts: cada etapa recibe solo lo que necesita.
Para probar en tu conversación actual
Abre tu conversación activa más larga y pregunta: «Enumera las instrucciones que te he dado desde el principio, copiándolas palabra por palabra». Compara con lo que realmente escribiste. Si faltan algunas o se han deformado, acabas de ver el límite en acción, y tienes que hacer tu nota de traspaso antes de seguir.
Para seguir leyendo
Entender la IA
Verificar una respuesta de la IA: qué comprobar y cómo
Fechas, cifras, fuentes inventadas, código: cómo comprobar una respuesta de la IA según el riesgo, sin pasarte el día en ello.
5 min de lectura
Entender la IA
La AI Act explicada sin rodeos: lo que te afecta
El reglamento europeo sobre IA clasifica los usos por nivel de riesgo. Qué cambia si usas un chatbot en el trabajo, y un prompt para hacer el inventario.
5 min de lectura
Entender la IA
Sesgos de la IA: cómo detectarlos y limitarlos
Estereotipos, reflejos anglosajones, complacencia: una prueba sencilla para detectar los sesgos de la IA y prompts para corregirlos en el día a día.
6 min de lectura