

 Français
 English
 Español
 Italiano
 Português
Tokens und Kontextfenster: warum die KI den Faden verliert
Wenn dein Chatbot nach dreißig Nachrichten den Faden verliert, ist das Mechanik. Was Tokens sind und wie du ein langes Gespräch durchhältst.
In der ersten Nachricht hast du deinen Chatbot gebeten, die Leser zu siezen und nie mehr als zehn Zeilen zu schreiben. Dreißig Austausche später duzt er alle und schreibt Textwüsten. Das ist weder böser Wille noch eine Panne: Deine Vorgabe ist womöglich einfach aus dem herausgerutscht, was er noch lesen kann.
Zwei Begriffe erklären dieses Phänomen und mit ihnen die meisten Blockaden bei langen Arbeiten: das Token und das Kontextfenster.
Ein Token ist ein Textstück
Sprachmodelle lesen weder Buchstaben noch genau Wörter. Sie zerlegen den Text in Stücke, die Tokens, die die Einheit sind, mit der sie arbeiten und mit der man ihre Kapazität misst. Wenn du sehen willst, wo dieser Schritt in der allgemeinen Funktionsweise steht, lies unsere Erklärung dazu, was in einem Sprachmodell passiert.
Die Zerlegung ist für einen Menschen nicht natürlich. Ein gängiges Wort wie „Haus“ kann ein einziges Token bilden, ein seltenes oder langes Wort wie „Donaudampfschifffahrtsgesellschaft“ wird in mehrere geteilt, und ein Satzzeichen kann für sich zählen. Die genaue Zerlegung hängt vom Modell ab.
Für Englisch nennt OpenAI eine oft zitierte Größenordnung: Ein Token entspricht etwa vier Zeichen, also ungefähr drei Vierteln eines Wortes. Andere Sprachen wie Deutsch verbrauchen bei vergleichbarer Länge oft etwas mehr. Merk dir vor allem die allgemeine Idee: Die Zahl der Tokens folgt der Länge des Textes, mit einer Ungenauigkeit. Manche Tools bieten einen Zähler an, falls du eine genaue Zahl brauchst.
Diese Zerlegung erklärt auch eine bekannte Merkwürdigkeit. Fragst du, wie viele „e“ ein Wort enthält, sieht das Modell die Buchstaben nicht unbedingt einzeln, was die Aufgabe schwieriger macht, als sie aussieht.
Das Kontextfenster, dein Arbeitstisch
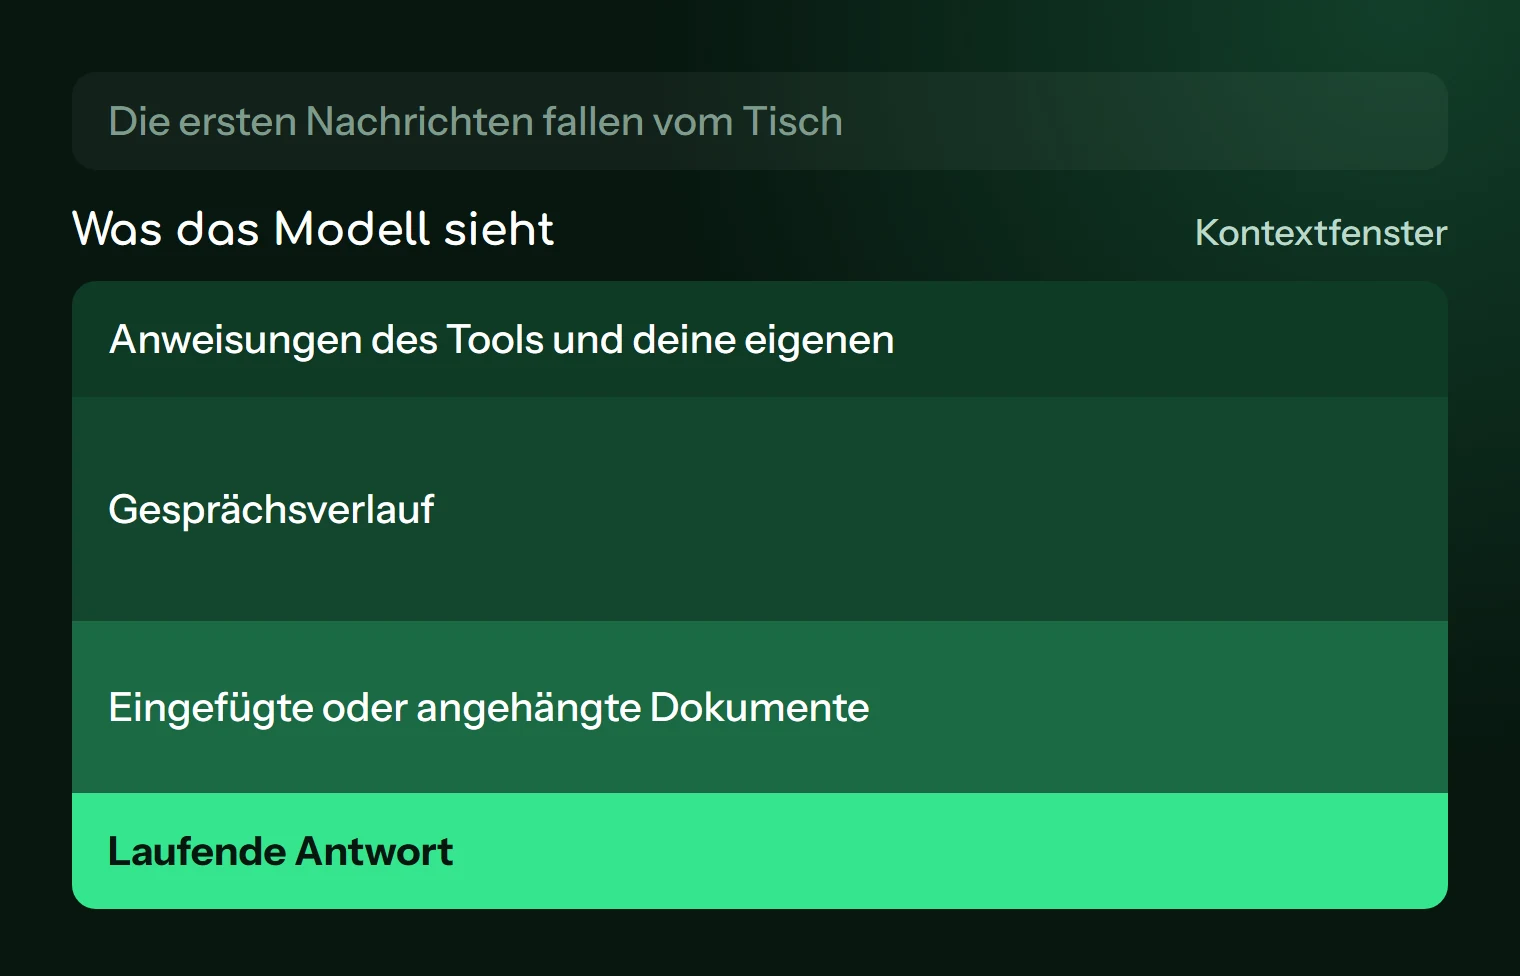
Das Kontextfenster ist die Menge an Tokens, die das Modell gleichzeitig berücksichtigen kann. Stell dir einen Arbeitstisch vor: Alles, was darauf liegt, ist sichtbar, alles, was vom Tisch fällt, existiert für das Modell nicht mehr.
Auf diesem Tisch liegt nicht nur deine letzte Frage:
- die Anweisungen des Tools, die du nicht siehst, und die benutzerdefinierten Anweisungen, die du gegebenenfalls festgelegt hast;
- der gesamte Verlauf des Gesprächs, deine Nachrichten wie seine Antworten;
- die eingefügten oder angehängten Dokumente, oder zumindest das, was das Tool daraus extrahiert hat;
- die Antwort, die gerade geschrieben wird und ebenfalls Platz beansprucht.
Dieser letzte Punkt überrascht oft. Füllst du den Tisch mit einem riesigen Dokument, bleibt weniger Spielraum für die Antwort, die abgeschnitten oder dünner werden kann.
Die Größe dieses Fensters variiert stark je nach Modell und Tarif, und sie ist in den letzten Jahren deutlich gewachsen. Die Zahl veraltet schnell, prüfe sie also in der Dokumentation deines Tools, wenn du sie brauchst.
Was passiert, wenn der Tisch überläuft
Auch hier hängt das Verhalten vom Tool ab, und es kann sich ändern. In der Praxis begegnen dir drei Fälle. Manche Tools lassen die ältesten Nachrichten fallen. Andere fassen den Anfang des Austauschs automatisch zusammen, was das Wesentliche bewahrt, aber Details verliert, etwa eine Stilvorgabe, die nebenbei gegeben wurde. Wieder andere halten an und bitten dich, ein neues Gespräch zu beginnen.
In den ersten beiden Fällen bekommst du oft keine Warnung. Diese Zeichen sollten dich aufmerksam machen:
- Er kehrt zu einer Gewohnheit zurück, die du korrigiert hattest;
- er fragt erneut nach einer Information, die schon gegeben wurde;
- er widerspricht einer Entscheidung, die früher getroffen wurde;
- er zitiert ein langes Dokument, das ganz am Anfang eingefügt wurde, nur ungenau.
Der letzte Fall verdient Misstrauen: Ein Modell, dem eine Passage fehlt, meldet das nicht immer, es kann trotzdem plausibel antworten.
Ein volles Fenster ist nicht der einzige Schuldige. Schon vor der Grenze sammelt ein langes Gespräch gescheiterte Versuche und Rückzieher an. All dieses Material bleibt auf dem Tisch und belastet die nächste Antwort. Ein kurzes, sauberes Gespräch liefert oft bessere Ergebnisse als ein langes, auch wenn die theoretische Kapazität bei Weitem nicht erreicht ist.
Was die Kosten betrifft, dienen Tokens bei APIs auch als Abrechnungseinheit, für die Eingabe wie für die Ausgabe. Verbraucher-Abos wenden eher Nutzungsgrenzen an, deren Details sich ändern. Wenn du nur die Weboberfläche nutzt, betreffen dich die Grenzen vor allem bei großen Mengen.
Ein langes Gespräch durchhalten, ohne den Faden zu verlieren
Nehmen wir eine Vereinsschatzmeisterin, die ihren Finanzbericht in mehreren Sitzungen vorbereitet. Sie sollte das einzelne Gespräch mit 80 Nachrichten unbedingt vermeiden. Das funktioniert, vom Einfachsten zum Strukturiertesten.
Eine Aufgabe, ein Gespräch. Wechselst du das Thema, öffne eine neue Unterhaltung. Die alte stört die neue nicht.
Korrigiere deine Nachricht, statt zu stapeln. Läuft die Antwort wegen deines Prompts schief, nutze die Funktion zum Bearbeiten der Nachricht, falls dein Tool sie anbietet. So legst du keine misslungene Antwort samt Korrektur zusätzlich auf den Tisch.
Füge den nützlichen Ausschnitt ein statt des ganzen Dokuments. Um Kapitel 3 einer Satzung gegenzulesen, genügt Kapitel 3. Für die Fälle, in denen du wirklich das ganze Dokument brauchst, schau dir unsere Methode für das Arbeiten mit langen Dokumenten an.
Gib wichtige Vorgaben im richtigen Moment neu. Eine Vorgabe, die kurz vor deiner Anfrage wiederholt wird, hat größere Chancen, befolgt zu werden, als eine, die dreißig Nachrichten weiter oben vergraben liegt.
Schreib eine Übergabenotiz. Das ist der lohnendste Handgriff. Bevor du ein Gespräch verlässt, das gut vorangekommen ist, bitte es, den Stand der Arbeit zusammenzufassen, und starte dann mit dieser Zusammenfassung in einer neuen Unterhaltung.
Wir setzen diese Arbeit in einem neuen Gespräch fort, in dem du auf nichts von dem Bisherigen Zugriff hast. Verfasse eine Übergabenotiz, die ich unverändert einfügen kann.

Sie muss enthalten:
- das Ziel der Arbeit, in zwei Sätzen;
- die getroffenen Entscheidungen und das, was verworfen wurde, mit dem Grund;
- die einzuhaltenden Stil- und Formatvorgaben, mit Zitat der Vorgaben, die ich dir gegeben habe;
- die genauen Daten und Zahlen, die erhalten bleiben müssen, ohne zu runden abgeschrieben;
- was noch zu tun ist, der Reihe nach.

Füge keine Information hinzu, die nicht in unserem Gespräch vorkommt. Bleibt ein Punkt unklar oder wurde er widerrufen, weise in einem Abschnitt „Zu bestätigen“ darauf hin.
Lies diese Notiz gegen, bevor du sie einfügst: Es ist eine vom Modell erzeugte Zusammenfassung, sie kann ein Detail vergessen oder eine Vorgabe falsch umformulieren. Kehrt dein Projekt oft wieder, kannst du es auch von Anfang an aufteilen, nach der Logik der Prompt-Kette: Jeder Schritt erhält nur, was er braucht.
Zum Ausprobieren in deinem laufenden Gespräch
Öffne dein längstes aktives Gespräch und frag: „Liste die Vorgaben auf, die ich dir von Anfang an gegeben habe, und schreib sie wortwörtlich ab.“ Vergleiche mit dem, was du tatsächlich geschrieben hast. Fehlen welche oder wurden sie verzerrt, hast du gerade die Grenze in Aktion gesehen, und deine Übergabenotiz steht an, bevor du weitermachst.
Als Nächstes lesen
KI verstehen
Eine KI-Antwort überprüfen: was du kontrollierst und wie
Daten, Zahlen, erfundene Quellen, Code: wie du eine KI-Antwort nach Risiko kontrollierst, ohne den ganzen Tag damit zu verbringen.
5 Min. Lesezeit
KI verstehen
Der AI Act einfach erklärt: Was dich betrifft
Die europäische KI-Verordnung ordnet Anwendungen nach Risikostufen ein. Was das ändert, wenn du bei der Arbeit einen Chatbot nutzt, plus ein Prompt für die Bestandsaufnahme.
5 Min. Lesezeit
KI verstehen
KI-Voreingenommenheit erkennen und eindämmen
Stereotype, angloamerikanische Reflexe, Gefälligkeit: ein einfacher Test, mit dem du Verzerrungen der KI aufspürst, und Prompts, die sie im Alltag abschwächen.
5 Min. Lesezeit