
Tokens et fenêtre de contexte : pourquoi l'IA perd le fil
Si ton chatbot perd le fil après trente messages, c'est mécanique. Ce que sont les tokens et comment tenir une longue conversation.
Au premier message, tu as demandé à ton chatbot de vouvoyer les lecteurs et de ne jamais dépasser dix lignes. Trente échanges plus tard, il tutoie tout le monde et écrit des pavés. Il ne s'agit ni de mauvaise volonté ni d'une panne : ta consigne a peut-être simplement glissé hors de ce qu'il arrive encore à lire.
Deux notions expliquent ce phénomène et, avec elles, la plupart des blocages sur les longs travaux : le token et la fenêtre de contexte.
Un token, c'est un morceau de texte
Les modèles de langage ne lisent ni des lettres ni exactement des mots. Ils découpent le texte en morceaux, les tokens, qui sont l'unité avec laquelle ils travaillent et avec laquelle on mesure leur capacité. Si tu veux voir où cette étape se place dans le fonctionnement général, lis notre explication de ce qui se passe dans un modèle de langage.
Le découpage n'est pas naturel pour un humain. Un mot courant comme « maison » peut former un seul token, un mot rare ou long comme « anticonstitutionnellement » sera coupé en plusieurs, et un signe de ponctuation peut compter à part. Le découpage exact dépend du modèle.
Pour l'anglais, OpenAI donne un ordre de grandeur souvent repris : un token représente environ quatre caractères, soit à peu près les trois quarts d'un mot. Le français en consomme souvent un peu plus, à longueur comparable. Retiens surtout l'idée générale : le nombre de tokens suit la longueur du texte, avec une marge d'approximation. Certains outils proposent un compteur si tu as besoin d'un chiffre précis.
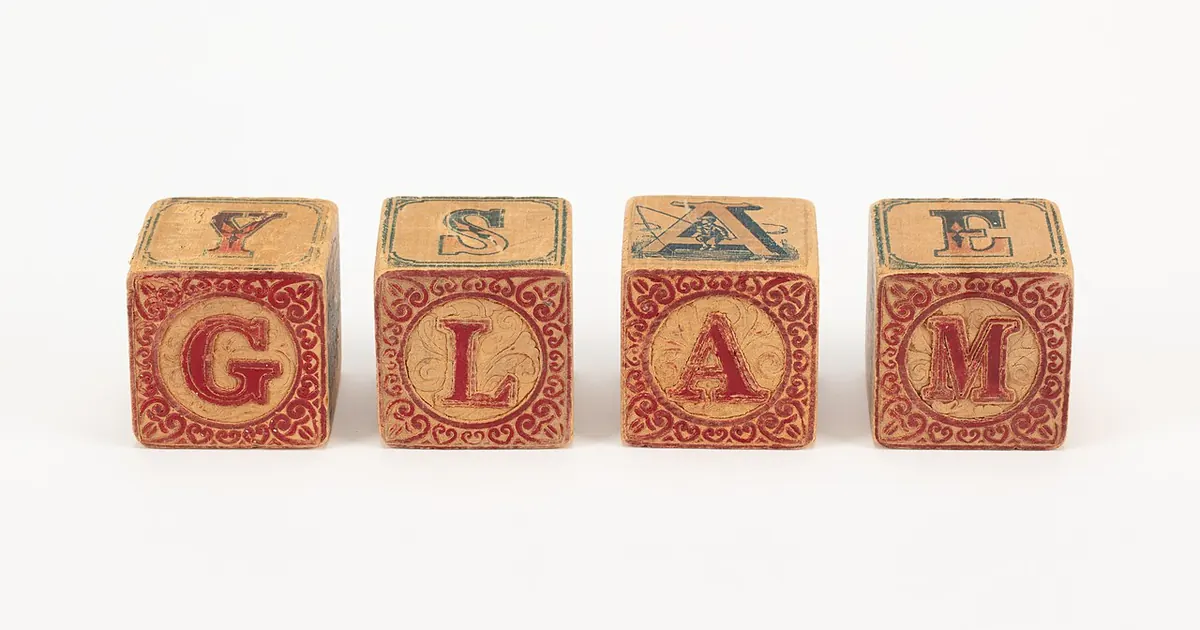
Ce découpage explique aussi une bizarrerie connue. Quand tu demandes combien de « e » contient un mot, le modèle ne voit pas forcément les lettres une à une, ce qui rend la tâche plus difficile qu'il n'y paraît.
La fenêtre de contexte, ta table de travail
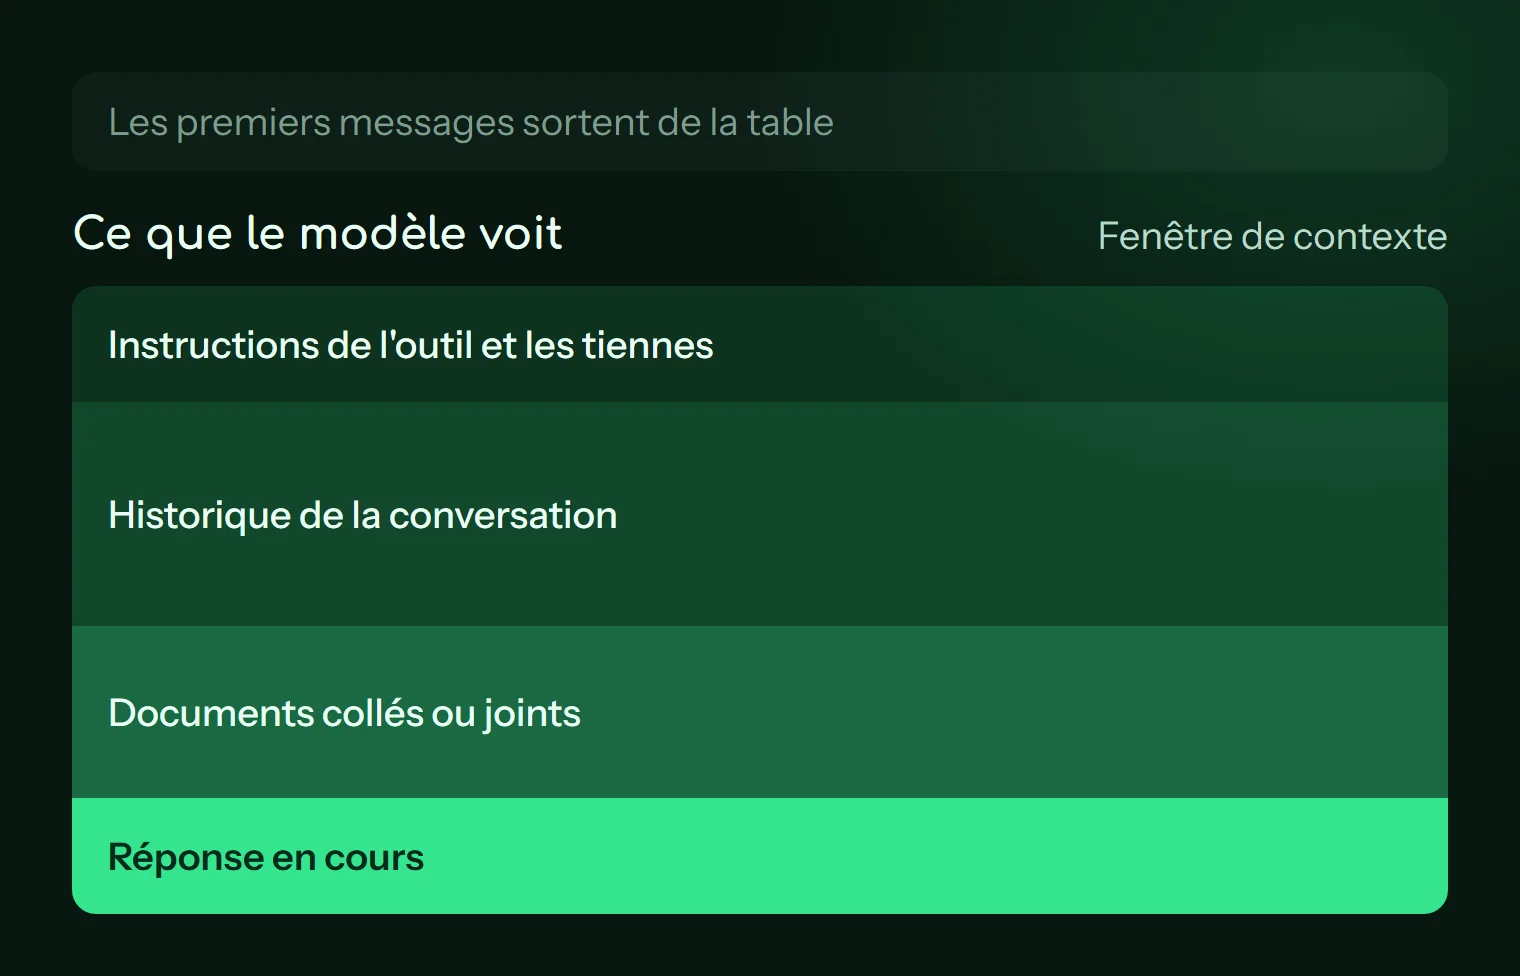
La fenêtre de contexte, c'est la quantité de tokens que le modèle peut prendre en compte en même temps. Représente-toi une table de travail : tout ce qui est dessus est visible, tout ce qui tombe de la table n'existe plus pour lui.
Sur cette table, il n'y a pas que ta dernière question :
- les instructions de l'outil, que tu ne vois pas, et les instructions personnalisées que tu as éventuellement définies ;
- tout l'historique de la conversation, tes messages comme ses réponses ;
- les documents collés ou joints, ou du moins ce que l'outil en a extrait ;
- la réponse en cours de rédaction, qui prend de la place elle aussi.
Ce dernier point surprend souvent. Si tu remplis la table avec un énorme document, il reste moins de marge pour la réponse, qui peut être tronquée ou appauvrie.
La taille de cette fenêtre varie beaucoup selon le modèle et l'offre, et elle a nettement augmenté ces dernières années. Le chiffre se périme vite, donc vérifie-le dans la documentation de ton outil au moment où tu en as besoin.
Ce qui se passe quand la table déborde
Là encore, le comportement dépend de l'outil, et il peut changer. Trois cas se rencontrent en pratique. Certains outils laissent tomber les messages les plus anciens. D'autres résument automatiquement le début de l'échange, ce qui préserve l'essentiel mais perd les détails, comme une consigne de style donnée en passant. D'autres encore s'arrêtent et te demandent de commencer une nouvelle conversation.
Dans les deux premiers cas, tu ne reçois souvent aucun avertissement. Voici les signes qui doivent t'alerter :
- il revient à une habitude que tu avais corrigée ;
- il redemande une information déjà donnée ;
- il se contredit par rapport à une décision prise plus tôt ;
- il cite de façon approximative un long document collé au tout début.
Le dernier cas mérite de la méfiance : un modèle à qui il manque un passage ne le signale pas toujours, il peut répondre quand même de façon plausible.
Une fenêtre pleine n'est pas le seul coupable. Même avant la limite, une longue conversation accumule des tentatives ratées et des contre-ordres. Toute cette matière reste sur la table et pèse sur la réponse suivante. Une conversation courte et propre donne souvent de meilleurs résultats qu'une conversation longue, même si la capacité théorique est loin d'être atteinte.
Côté coût, les tokens servent aussi d'unité de facturation pour les API, à l'entrée comme à la sortie. Les abonnements grand public appliquent plutôt des limites d'usage, dont le détail évolue. Si tu n'utilises que l'interface web, les limites te concernent surtout quand tu travailles sur de gros volumes.
Tenir une conversation longue sans perdre le fil
Prenons une trésorière d'association qui prépare son rapport financier en plusieurs séances. Elle a tout intérêt à éviter la conversation unique de 80 messages. Voici ce qui marche, du plus simple au plus structuré.
Une tâche, une conversation. Quand tu changes de sujet, ouvre une nouvelle discussion. L'ancienne ne parasitera pas la nouvelle.
Corrige ton message au lieu d'empiler. Si la réponse part de travers à cause de ton prompt, utilise la fonction de modification du message, si ton outil la propose. Tu évites d'ajouter à la table une réponse ratée et sa correction.
Colle l'extrait utile plutôt que le document entier. Pour relire le chapitre 3 d'un règlement intérieur, le chapitre 3 suffit. Pour les cas où tu as vraiment besoin de tout le document, consulte notre méthode pour travailler avec de longs documents.
Remets les consignes importantes au bon moment. Une consigne rappelée juste avant ta demande a plus de chances d'être suivie qu'une consigne enfouie trente messages plus haut.
Fais une note de passation. C'est le geste le plus rentable. Avant de quitter une conversation qui a bien avancé, demande-lui de résumer l'état du travail, puis repars de ce résumé dans une discussion neuve.
Nous allons poursuivre ce travail dans une nouvelle conversation, où tu n'auras accès à rien de ce qui précède. Rédige une note de passation que je pourrai coller telle quelle.

Elle doit contenir :
- l'objectif du travail, en deux phrases ;
- les décisions prises et ce qui a été écarté, avec la raison ;
- les consignes de style et de format à respecter, en citant celles que je t'ai données ;
- les données et chiffres exacts à conserver, recopiés sans les arrondir ;
- ce qui reste à faire, dans l'ordre.

N'ajoute aucune information qui n'apparaît pas dans notre conversation. Si un point reste flou ou a été contredit, signale-le dans une section « À confirmer ».
Relis cette note avant de la coller : c'est un résumé produit par le modèle, il peut oublier un détail ou reformuler une consigne de travers. Si ton projet revient souvent, tu peux aussi le découper dès le départ, en suivant la logique de la chaîne de prompts : chaque étape reçoit seulement ce dont elle a besoin.
À essayer sur ta conversation en cours
Ouvre ta plus longue conversation active et demande : « Liste les consignes que je t'ai données depuis le début, en les recopiant mot pour mot. » Compare avec ce que tu as réellement écrit. Si certaines manquent ou ont été déformées, tu viens de voir la limite en action, et tu as ta note de passation à faire avant de continuer.
À lire ensuite
Comprendre l'IA
Vérifier une réponse de l'IA : quoi contrôler, et comment
Dates, chiffres, sources inventées, code : comment contrôler une réponse de l'IA selon le risque, sans y passer ta journée.
5 min de lecture
Comprendre l'IA
Biais de l'IA : comment les repérer et les limiter
Stéréotypes, réflexes anglo-saxons, complaisance : un test simple pour détecter les biais de l'IA et des prompts pour les corriger au quotidien.
6 min de lecture
Comprendre l'IA
Comment fonctionne un modèle de langage, expliqué sans jargon
Prédiction du mot suivant, entraînement, attention : ce qui se passe quand l'IA répond, et pourquoi elle invente parfois avec aplomb.
10 min de lecture